
在 Self-Attention 的運算裡,Q、K、V 並不是什麼神秘的特殊物件,它們純粹就是同一個輸入向量,分別乘上三張不同的權重矩陣後,投影出來的向量。所以它們本質上就是 3 個帶有各自意義的向量:
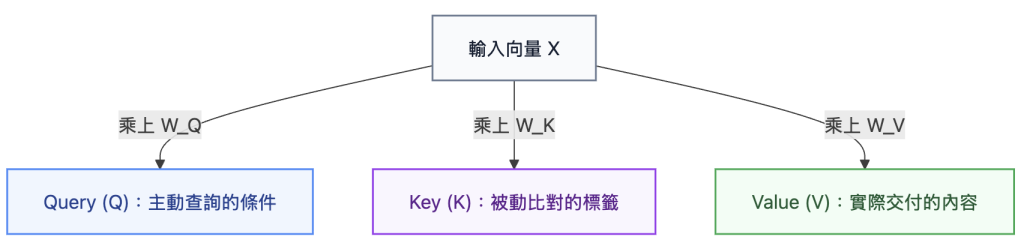
這裡可能有個疑問:「模型訓練時怎麼知道這些矩陣跟向量的意義的?」
確實,一開始訓練時,模型是不知道這些權重矩陣跟向量的意義的,它們在訓練初期只是一堆亂數,本身沒有意義。那是誰賦予它們意義呢?是「人」。人期望這些向量具有這些意義,並執行對應的運算,所以設計了這套運算流程,期望這樣的架構可以引導模型理解這些權重矩陣與向量的意義。對於模型而言,它只是做完這些運算,然後根據預測結果算 Loss、回傳梯度更新參數。這是我認為最佩服想出這個架構的人的地方!好啦,我只是在自言自語而已哈哈,我們繼續來看它到底怎麼算的~
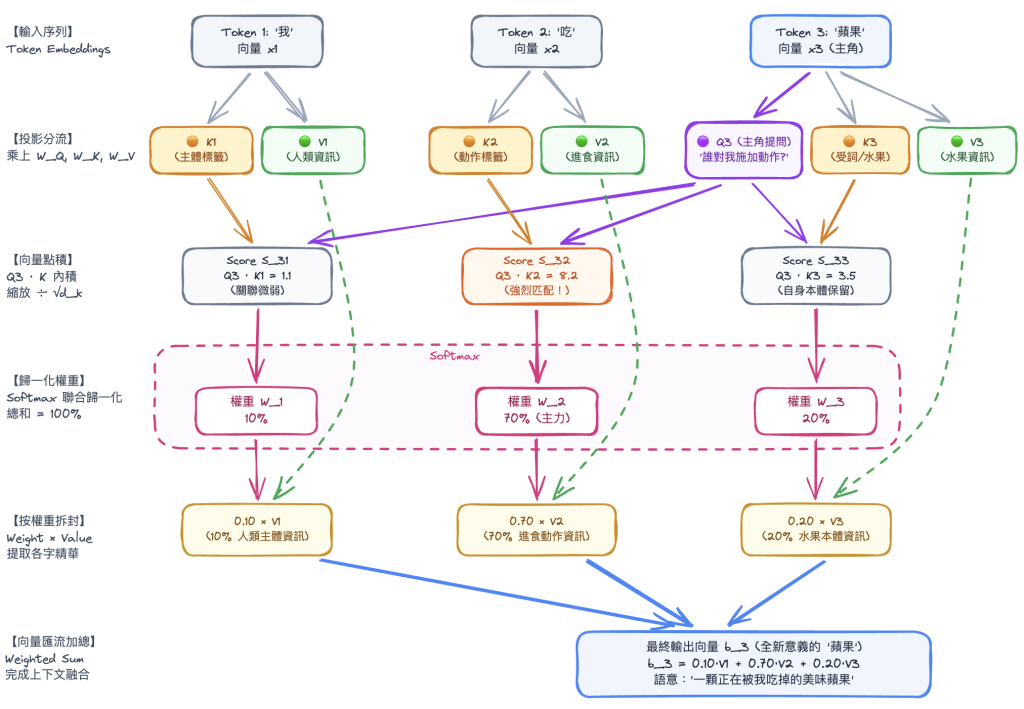
假設今天我們輸入的句子是:「我吃蘋果」,而它被 Tokenizer 切成三個 Token,分別是「我」、「吃」、「蘋果」。接著經過 Embedding Table 將這三個轉成 3 個 Embedding 向量,假設維度是 4096 維。
記得我們昨天講的 Multi-Head Attention 嗎?假設在這個例子裡我們總共分了 32 個 Head,那每個 Head 的輸入向量維度就變成了 128 維(4096 / 32),也就是圖中的 x1, x2, x3。上方這張圖就是在一個 Head 內的運算,所以可以想像如果有 32 個 Head,當一個 Embedding 向量輸入進來,就會切成 32 個跟上面一樣的運算同時進行著。
(實際上工程實作時可能不是這樣切,更常見的是先將輸入向量 x 乘上完整的投影矩陣轉出 Q, K, V,再各自切出各個 Head 要的維度區段,例如:
[0-127]給第一個 Head、[128-255]給第二個 Head...依此類推。)
前幾天一直提到 Attention 這個詞,但好像沒有好好解釋過。Attention 這個東西可以想成是 「關注度」,也就是現在這個 Token 關注其他 Token 的程度有多大。有了對每一個 Token 的關注程度,就能把它對應比例的資訊拿過來跟自己做計算,計算後的結果就會同時包含自己跟對方的資訊在裡面,達到「交換上下文資訊」的目的。這裡我們要做的是 「計算 Token 之間的 Attention」,所以每個 Token 都會跟每個 Token 計算一次關注度,包含自己。
假設模型現在正要計算 Token 3「蘋果」 的新向量。剛剛說了給一個 Input 向量都會轉成自己的 Q, K, V 向量,這裡因為我們是計算 Token 3 的 Attention,不會用到 Q1 跟 Q2,因此在圖上沒有畫出來。而我們現在的所在位置就在 「紫色 Q3」 的地方,接著順著箭頭往下走:
(這裡算出來的內積數值只是我隨便假設的)
「蘋果」想知道自己在整個句子裡跟誰最有關係,所以它派出自己的 Q3,分別去跟句子裡每一個人的 K(特徵標籤) 做內積(也就是高中學過的向量內積,兩個向量方向越接近,內積數值越大;反之則越小):
為什麼公式要除以「根號 d_k」?(d_k 是向量的維度,在我們的例子裡是 128)
其實單純是為了防止數值爆炸而已。因為向量維度有 128 維,一百多個數字乘乘加加起來,內積算出來的數值很容易變得非常大。如果數字太大,下一步算出來的結果就會很極端,所以除以維度的開根號,純粹只是把數值縮小、拉回平穩的範圍。
因為大模型是「猜下一個字」的自回歸生成,所以有一個鐵則:不能偷看後面的字。
假設今天的句子後面還有字(例如「我 吃 蘋果 很 開心」),在計算「蘋果」的當下,模型會把來自「很」跟「開心」的內積結果強制設成負無窮大。這樣在後面算權重時,那些字的權重就會直接歸零,等於沒有關注。而在我們圖中「我 吃 蘋果」的例子裡,「蘋果」已經是最後一個字了,所以前面的 1、2、3 都可以正常看到。
拿到剛剛那三個數值(1.1、8.2、3.5)之後,模型會把它們送進 Softmax。Softmax 會透過一個數學轉換,把輸入進來的任意數值轉成介於 0 到 1 之間的值,且所有數值的總和為 1。 可以看到圖中 Softmax 那圈虛線外框,代表 Softmax 是把這三個數值綁在一起同時計算,轉成「加總剛好等於 100%(1.0)」的權重比例:
有個重要的細節:「蘋果」也分給了自己 20% 的關注度。這就是為什麼它叫 「Self-Attention(自注意力)」!如果一個字不看自己的 K 跟 V,那它融合完之後就會忘記自己原本是個「水果」,本體特徵就直接消失了。
算好百分比之後,最後一步非常直覺,就是依照剛才算出來的比例,去把大家的 V(實質資訊)打包帶走:
最後,把這三包乘好比例的向量全部加在一起,就得到了圖最下方的最終輸出向量 b_3! 這時候的 b_3,已經不再是一開始那個字典裡孤立的「蘋果」,而是變成了一個 「融合了上下文資訊、代表一顆正在被我吃掉的蘋果」 的全新向量。這樣 Attention 就達到讓模型「理解上下文」的目的了!
特別提醒,我們上面圖示的步驟,只是單獨以 Q3 為主角在某一個 Head 裡的計算。實際上,Q1 與 Q2 也會做一模一樣的操作,所以這層運算最後會輸出 3 個融合語意過後的向量,維度跟最初的 Input 向量完全一樣,接著再被送去做昨天文章介紹的 FFN 與殘差連接。
也正因為輸入的向量數量跟向量維度始終保持一致,這個 Decoder Block 架構得以不斷疊加很多層(例如 32 層、80 層甚至上百層)!
另外,呼應第一天的說法,Self-Attention 比傳統 RNN 快多了! 因為每個 Token 都可以獨立進行自己的 Q、K、V 投影與計算,而且這中間本質上全部都是矩陣乘法,非常適合透過 GPU 的平行計算能力進行硬體加速,這也是 Transformer 在現代大模型時代勝出的關鍵原因。


 iThome鐵人賽
 看影片追技術